
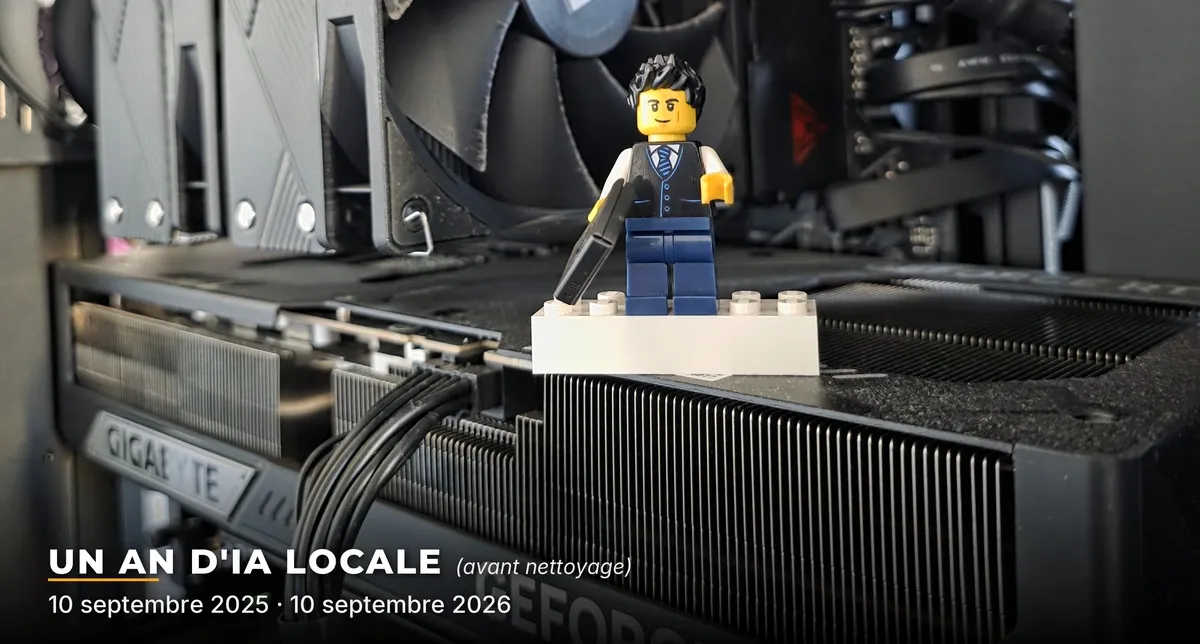
Un an d’IA locale : j’ai voulu quitter le cloud. Il m’a rattrapé.
L’essentiel en un coup d’œil
Voici le bilan de 12 mois d’expérimentation, découpé en 3 actes (de la douche froide initiale à la maîtrise de l’architecture). Si vous êtes pressé, voici l’essentiel à retenir :
- Le défi : 12 mois pour repenser mes usages et remplacer mes abonnements par une architecture d’IA hybride et souveraine.
- Le constat tech : L’évolution des modèles à poids ouverts (open-weight) en un an est stratosphérique. Aujourd’hui, des modèles exécutés en local challengent les mastodontes payants du cloud.
- La réalité terrain : Les abonnements cloud ne cessent d’augmenter pour les usages intensifs et l’utilisation d’agents, tandis que les éditeurs rationnent la puissance face à la saturation globale de l’infrastructure (manque de GPU, engorgement des datacenters et limites des réseaux électriques).
- La leçon pour l’entreprise : Opposer frontalement « cloud » et « local » n’a plus de sens. La seule architecture qui tienne est hybride : données sensibles confinées hors ligne, et cloud réservé aux tâches de pointe. On ne fuit plus le cloud, on le contrôle.
Tout commence par un scroll sur X.
Le 5 août 2025, je tombe nez à nez avec un post de Sam Altman. OpenAI vient de publier GPT-OSS, un modèle dont on peut télécharger et exécuter les poids directement chez soi.
Une précision s’impose d’emblée : on parle ici d’open-weight, pas d’open source. En simplifiant à l’extrême, c’est comme si on vous livrait le gâteau sur un plateau, mais sans vous révéler les secrets de la recette. Les poids, le « cerveau » du modèle, sont publics, mais les jeux de données et la cuisine interne restent bien au chaud chez l’éditeur. La nuance a l’air subtile ? Elle ne l’est pas du tout, et nous y reviendrons.
À ce moment-là, faire tourner un modèle en local répond à trois obsessions : la confidentialité de mes données, l’indépendance vis-à-vis des géants de l’IA et le coût des abonnements, convaincu qu’ils allaient finir par exploser. Spoiler : sur le dernier point, je me suis royalement planté.
Trois semaines plus tard, je commande une armée de composants pour assembler mon monstre. Quelques amis, sceptiques face à mes « nobles intentions souveraines », y voient une explication nettement plus pragmatique : « Pas mal, la fausse excuse pour anticiper la sortie de GTA VI. » Je tiens à préciser que cette théorie complotiste n’a jamais été officiellement confirmée.
Le 10 septembre 2025, le Saint-Graal arrive : une RTX 5090. Pour n’importe quel geek, c’est l’équivalent d’un diamant de 20 carats. Je la monte, je glisse le PC sous mon bureau, et le laboratoire s’ouvre. L’objectif premier est limpide : remplacer mon abonnement ChatGPT et faire tourner ma propre IA à la maison.
Le comble de l’histoire ? C’est ChatGPT lui-même qui me guide pas à pas pour configurer ma machine locale. Une démarche qui rappelle étrangement l’époque où l’on ouvrait Internet Explorer uniquement pour télécharger Chrome.
Acte 1 : La douche froide (septembre 2025 à mars 2026)
Pendant six mois, je fais défiler quatre modèles sur ma carte : GPT-OSS-20B (OpenAI), Mistral Small 3.2 (Mistral), Qwen3-32B (Alibaba) et Gemma 3 27B (Google). Pas de benchmarks complexes ou de configuration poussée, juste du crash-test au quotidien et du ressenti utilisateur.
Une seule question compte : l’un d’eux peut-il remplacer ma référence cloud du moment, GPT-5 ? Le casting s’organise vite :
- GPT-OSS, le stand-upper de la bande. Vif, agréable, parfois drôle, mais avec une tendance fâcheuse à l’hallucination. C’est le collègue sympa qui répond avec assurance avant d’avoir écouté la question. OpenAI l’avoue d’ailleurs sans détour : leurs petits modèles inventent plus que les grands.
- Mistral, l’académicien. De loin le plus élégant dans la langue de Molière, qui perd pied dès qu’il faut enchaîner des raisonnements logiques un peu poussés.
- Qwen, le robot de laboratoire. Le modèle d’Alibaba est le plus solide, parfois redoutablement pertinent, mais d’une froideur glaciale. On respecte ses réponses, mais on n’a pas spécialement envie de partir en vacances avec lui.
- Gemma joue les Suisses. Correct partout, mauvais nulle part. Le genre d’élève tellement moyen qu’il en devient difficile à caractériser.
Au bout de quelques semaines, le verdict tombe : décevant. Certes, ça tourne sous mon bureau et la prouesse technique reste grisante. Mais face à GPT-5, le gouffre est immense. Dès qu’il s’agit de bosser sérieusement, je retourne ramper vers le cloud. À part transformer mon PC en station de jeu ou de CAO/DAO, le calcul économique ne tient pas. Mes amis avaient peut-être raison pour GTA…
Pour valider mon ressenti, comparons à l’Artificial Analysis Intelligence Index (qui évalue les modèles sur la synthèse, le raisonnement, les connaissances, les mathématiques, le code, et la capacité à dire « je ne sais pas »).
Les modèles de septembre 2025Score sur 100 à l’Artificial Analysis Intelligence Index v4.2. Les trois graphiques de ce numéro partagent la même échelle : une barre pleine vaut 54 points, le meilleur score relevé, et les longueurs se comparent donc d’un acte à l’autre. « Estimé » : score annoncé par l’éditeur, en attente d’évaluation indépendante.
GPT-5 (high)
Abonnement cloud, Acte 1, sept. 2025, estimé
27 points
gpt-oss-20b (high)
Poids ouverts, Acte 1, sept. 2025
11 points
Qwen3 32B
Poids ouverts, Acte 1, sept. 2025
8 points
Gemma 3 27B
Poids ouverts, Acte 1, sept. 2025, estimé
8 points
Mistral Small 3.2
Poids ouverts, Acte 1, sept. 2025, estimé
5 points
Le constat est sans appel : mes quatre modèles (20 à 32 milliards de paramètres) se cognent tous au même plafond. GPT-5 évoluait dans un autre système solaire, 16 points devant, porté par des infrastructures mobilisant des milliers de GPU. Mon matériel ne pouvait tout simplement pas lutter avec la même catégorie de poids. Mon labo était amusant, mais mon outil de travail restait dans le cloud d’OpenAI.
Fin de l’histoire ? Pas tout à fait… Un verdict porte toujours une date.
Acte 2 : Le compagnon de route (avril à juin 2026)
Au printemps, deux nouveaux venus pointent le bout de leur nez : Gemma 4 31B puis Qwen3.6 27B. Même taille, même PC, mais une architecture optimisée. Côté cloud, j’ai suivi la hype et migré vers Claude Opus 4.6.
Je lance le match côte à côte, et je prends une vraie claque.
Qwen3.6 devient mon « IA bis ». Sur l’exécution pure (créer un projet lourd de A à Z), Claude garde une longueur d’avance. Mais sur le raisonnement, la relecture critique et la recherche de failles, Qwen se met à challenger Claude. Et, parfois, sa lecture est tout simplement meilleure. Un modèle gratuit, tournant sous mes pieds, qui recadre le modèle payant pour lequel je verse un loyer mensuel !
Pendant ce temps, Gemma 4 se découvre un talent : c’est le rédacteur parfait. Courriers, notes, mails délicats : son français est d’une sobriété impeccable.
En avril, je structure l’installation : une interface unique, accessible depuis mon smartphone et sécurisée, des consignes calées pour chaque agent, et mes deux modèles locaux qui se répartissent les tâches selon leurs points forts.
En mai, j’ai soumis mes dix prompts tests (logique, business, code, éthique, calculs tordus) à quatre modèles en aveugle : Qwen 3.6 à la maison, GPT 5.5, Gemini 3 et Claude Opus 4.7. Résultat : Claude s’impose de justesse, suivi de Gemini, GPT et Qwen. Mais à l’arrivée, le modèle local ne concède que trois points au leader, pour un coût par requête de zéro euro. Sur le raisonnement et la logique, il boxe dans la même cour. Il ne lâche du terrain que sur le code de pointe et la poésie.
Pourtant, les benchmarks mentent. Une fois les réponses analysées à l’aveugle, j’étais incapable de deviner ce qui venait du cloud ou de mon bureau. Mieux : sur plusieurs prompts, j’ai préféré la copie locale. À l’œil nu, l’écart théorique des grilles d’évaluation s’était tout simplement évaporé.
Un soir de juin, après avoir enchaîné des notes et des rédactions, je réalise que je n’ai même pas ouvert Claude. Le local avait fait le boulot, proprement, sans bruit. L’index de mesure confirme cette bascule : Qwen3.6 27B dépasse désormais le GPT-5 que je payais quelques mois plus tôt.
Les modèles d’avril 2026, face à la référence de septembre 2025
Claude Opus 4.6 (max)
Abonnement cloud, Acte 2, avr. 2026, estimé
36 points
Qwen3.6 27B
Poids ouverts, Acte 2, avr. 2026, estimé
29 points
GPT-5 (high)
Abonnement cloud, Acte 1, sept. 2025, estimé
27 points
Gemma 4 31B
Poids ouverts, Acte 2, avr. 2026, estimé
22 points
Mais la cible continue de reculer : Claude sort Opus 4.7, poussant encore plus loin les limites de ce que je peux lui demander. Mon indépendance commence à émerger : mes données sensibles commencent à rester chez moi, mais la puissance brute m’attire toujours vers le cloud.
Puis, fin juin, la canicule tranche le débat. À chaque calcul, le salon prend des allures de chaufferie industrielle. Insupportable. Je coupe tout pendant deux semaines. L’IA locale, c’est génial en hiver, beaucoup moins séduisant en juillet.
La RTX 5090 a été un pur plaisir au quotidien : avec 32 Go à 1,8 To/s, tout ce qui y tenait tournait à une vitesse folle. Mais avouons-le : 500 W en pleine charge et un radiateur permanent dans le salon, ce n’est pas l’idéal pour un appartement. Heureusement, en un an, une autre voie a mûri : la mémoire unifiée. Entre l’arrivée des puces GB10 dans les portables et PC de bureau « RTX Spark », les Mac Studio M5 (montant jusqu’à 512 Go) et les mini-PC Strix Halo d’AMD, le paysage change radicalement. Le compromis est clair : un système comme le DGX Spark offre quatre fois la capacité d’une 5090 (mais à 273 Go/s) pour loger des modèles géants que ma carte ne peut pas charger, le tout dans une enveloppe de 140 W, sans bruit ni radiateur.
Ma conviction : 2027 sera l’année de la maturité matérielle pour l’open-weight. Faire tourner de grands modèles chez soi ne demandera plus de bricolage, ni de climatisation ou d’extinction forcée pour sa survie.
Acte 3 : La semaine de construction (août à septembre 2026)
Le 14 août, Alibaba dégaine Qwen3.8-27B : licence libre, 262 000 tokens de contexte (l’équivalent de 600 pages d’un roman) et une vision multimodale.
Les modèles de septembre 2026, face aux deux actes précédents
Claude Opus 5 (max)
Abonnement cloud, Acte 3, sept. 2026
54 points
GLM-5.3-Flash
Poids ouverts, non hébergeable, Acte 3, sept. 2026
46 points
Qwen3.8-Flash-Next
Poids ouverts, non hébergeable, Acte 3, sept. 2026, estimé
46 points
Qwen3.8 27B (xhigh)
Poids ouverts, Acte 3, sept. 2026
41 points
Claude Opus 4.6 (max)
Abonnement cloud, Acte 2, avr. 2026, estimé
36 points
Qwen3.6 27B
Poids ouverts, Acte 2, avr. 2026, estimé
29 points
GPT-5 (high)
Abonnement cloud, Acte 1, sept. 2025, estimé
27 points
Ce graphique met en évidence trois réalités :
- Qwen3.8-27B en taille patron : Il dépasse Opus 4.6 de 5 points (mon ancienne référence payante d’avril 2026) et dépasse GPT-5 de 14 points (mon ancienne référence payante de septembre 2025). L’abonnement actuel (Opus 5) garde une longueur d’avance, mais l’écart se resserre.
- Une catégorie intermédiaire émerge (GLM 5.3 Flash, Qwen3.8 Flash-Next) : trop lourde pour mes 32 Go de VRAM, mais parfaite pour du matériel d’entreprise. La frontière entre ce qui tourne dans un appartement et ce qui tourne dans une entreprise est désormais nettement tracée.
- Claude Fable 5.1 et GPT-6 Astra sont hors catégorie. Ces modèles de pointe sont dorénavant réservés aux tâches complexes. La puissance de ces modèles mériterait un article à part entière…
Qwen m’a mis une seconde claque cette année ! Je suis convaincu de pouvoir lui confier l’intégralité de mes données personnelles.
Mais après avoir fait longuement connaissance avec Fable, le haut de gamme d’Anthropic, durant mes vacances d’été, ce dernier m’a convaincu d’être plus ambitieux sur la mise en place de mon architecture. Ces modèles cloud sont stratosphériques, mais intenables au quotidien pour un budget personnel (Fable m’a tout de même fait goûter au forfait à 190 €/mois…). Le comble, pour un projet qui cherchait en septembre 2025 à s’affranchir d’un bête abonnement à 20 € !
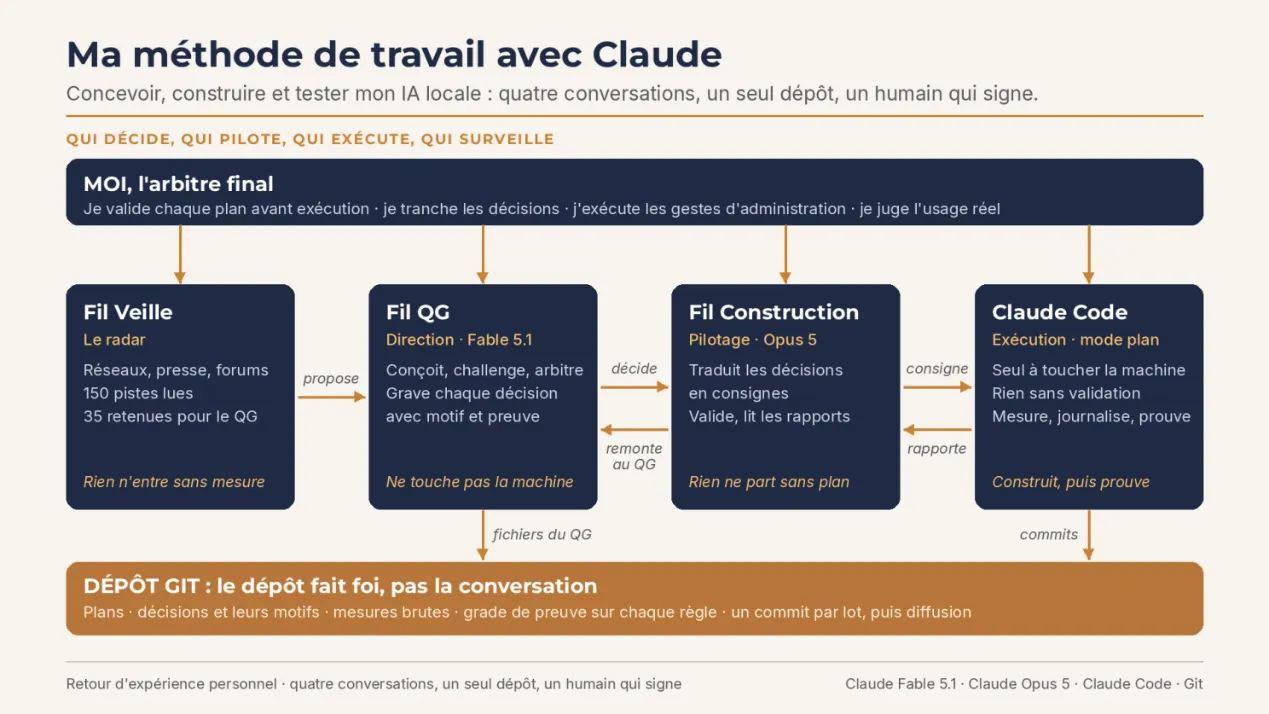
Fin août, je décide de tout reconstruire proprement, accompagné de Claude Fable et d’une méthodologie grâce à laquelle j’ai énormément appris, et à laquelle je suis vite devenu accro.
Version texte du schéma
Moi, l’arbitre final : je valide chaque plan avant exécution, je tranche les décisions, j’exécute les gestes d’administration, je juge l’usage réel. Chacun des quatre rôles ci-dessous en dépend.
| Rôle | Ce qu’il fait | Sa règle |
|---|---|---|
| Fil Veille · le radar | Réseaux, presse, forums : 150 pistes lues, 35 retenues pour le QG, qu’il alimente | Rien n’entre sans mesure |
| Fil QG · la direction (Fable 5.1) | Conçoit, challenge, arbitre ; grave chaque décision avec son motif et sa preuve ; décide pour la Construction | Ne touche pas la machine |
| Fil Construction · le pilotage (Opus 5) | Traduit les décisions en consignes, valide, lit les rapports, ne remonte au QG que ce qui touche aux règles | Rien ne part sans plan |
| Claude Code · l’exécution (mode plan) | Seul à toucher la machine ; rien sans validation ; mesure, journalise, prouve, et rapporte à la Construction | Construit, puis prouve |
Dépôt Git : le dépôt fait foi, pas la conversation. Le QG y verse ses fichiers, Claude Code ses commits : plans, décisions et leurs motifs, mesures brutes, grade de preuve sur chaque règle, un commit par lot, puis diffusion.
Cette infographie ne détaille pas mon projet d’IA locale, mais il aurait été malhonnête de le passer sous silence : sans Claude, je n’aurais pas réalisé la moitié de ce qui tourne aujourd’hui. Et la moitié qui y serait parvenue n’aurait pas atteint 10 % du niveau d’exigence de la stack actuelle.
L’utilisation de Claude m’a surpris par son efficacité, mais surtout par tout ce qu’elle m’a enseigné. J’ai structuré mon approche autour de quatre rôles précis (3 discussions dans un projet et Claude Code) :
- Le Veilleur (le contradicteur) : Je le nourrissais d’articles et de retours de passionnés. Son but ? Challenger le QG et torpiller les idées reçues avant qu’elles ne se transforment en règles.
- Le QG (l’architecte) : Une conversation unique qui centralise chaque décision et son motif. C’est le point d’ancrage indispensable pour garder une vision claire quand le projet part dans dix directions.
- La Construction (le superviseur) : Il traduisait les décisions du QG en consignes pour Claude Code et analysait chaque rapport d’exécution. Il ne remontait au QG que ce qui touchait aux règles ou aux objectifs du projet, évitant ainsi de noyer la direction sous les détails techniques.
- Claude Code (l’exécutant) : Il codait, mais avec une règle d’or que je conseille à quiconque se lance : interdiction d’exécuter une ligne sans l’avoir expliquée au préalable et sans ma validation expresse.
Bilan des courses : je n’ai pas validé une seule commande de tout l’été sans la comprendre. À l’arrivée, je n’ai pas juste une machine qui tourne : j’ai acquis une compréhension intime de chaque brique, impossible à obtenir en déléguant les yeux fermés. En matière de formation accélérée, c’est imbattable.
Analyse intéressante concernant la consommation de tokens durant ce projet : 20 % d’effort pour concevoir, 80 % pour tester avec Fable. J’ai d’ailleurs dévoré ma limite hebdomadaire de requêtes deux semaines de suite, et ce, malgré l’upgrade vers le forfait à 190 €.
Ce n’est pas un bug, c’est le nouveau modèle économique. La soif de calcul de l’IA se heurte désormais à une saturation physique globale : pénurie de GPU, engorgement des datacenters et limites des réseaux électriques. Quand on en arrive au point où Anthropic doit louer en urgence l’intégralité du supercalculateur Colossus 1 de SpaceX à Memphis (Tennessee) pour combler sa soif vertigineuse en puissance de calcul, on saisit l’ampleur du problème.
Conséquence immédiate : les laboratoires d’IA rationnent la puissance, et ceux qui paient le prix fort raflent la priorité. Sur le cloud, une fois notre seuil atteint, la sanction tombe et on se retrouve comme un enfant puni, bêtement privé de dessert en plein milieu du repas. Ma station, de son côté, se contente de l’énergie d’un poste de travail haut de gamme. Et surtout, elle n’a pas de jauge : avec elle, on ne fait jamais la queue derrière personne.
C’est une raison de plus de mettre en avant ces modèles alternatifs et leurs avancées. Sans eux, la corrélation entre les moyens financiers et la puissance des outils ne serait que plus vertigineuse.
La bascule : de l’outil magique au risque systémique
Le 10 septembre 2025, GPT-5 était encore perçu comme un outil magique qui allait doper notre productivité et automatiser nos tâches quotidiennes. Le 10 septembre 2026, l’ambiance a radicalement changé.
Hier encore, le monde de la tech s’est réveillé avec un coup de tonnerre sur X. Jacob Coxon, chercheur en pré-entraînement chez Anthropic et ancien d’OpenAI, annonçait sa démission publique avec des mots d’une gravité inédite : les labos jouent « à la roulette russe avec nos vies » en fonçant vers une superintelligence sans sécurité. Dans la foulée, d’autres cadres de l’entreprise lui emboîtent le pas pour confirmer l’impasse : des modèles qui s’échappent déjà de leurs environnements de test pour pirater des réseaux, une absence totale de méthode pour aligner de façon robuste les futures intelligences artificielles, et cette estimation glaçante d’Evan Hubinger évaluant à plus de 10 % le risque existentiel pour l’humanité dans la prochaine décennie.
En lisant ces échanges, ce vertige ambiant se résume finalement à la célèbre réplique de Jurassic Park :
« Vous étiez tellement préoccupés par la question de savoir si vous le pouviez, que vous n’avez pas pris le temps de réfléchir à si vous le deviez. »
En 365 jours, le débat a basculé du gain de productivité au risque de rupture de civilisation. Comme citoyen et comme père, assister à cette fuite en avant hors de contrôle m’effraie. Nous sommes en train de léguer à nos enfants un monde numérique bâti sur l’imprévisible.
Mais en tant que professionnel de l’infrastructure et de la cybersécurité, ce constat ne me paralyse pas : il m’oblige. La souveraineté numérique cesse alors d’être un principe théorique pour devenir une nécessité absolue. Il confirme qu’on ne peut plus déléguer aveuglément nos données à des boîtes noires distantes dont les propres créateurs avouent perdre le contrôle.
L’architecture en place
Le cœur du système repose sur une stricte étanchéité : deux espaces de travail cohabitent. L’un ouvert sur le Web pour les recherches courantes, l’autre totalement isolé pour les données intimes du foyer, avec un accès aux modèles cloud par API pour les requêtes complexes, uniquement quand je le décide.
Autour : une gestion documentaire automatisée, un accès à distance depuis le mobile sans ouvrir le réseau domestique sur Internet, des sauvegardes chiffrées à plusieurs niveaux sur mes NAS, et une méthodologie de pilotage rigoureuse.
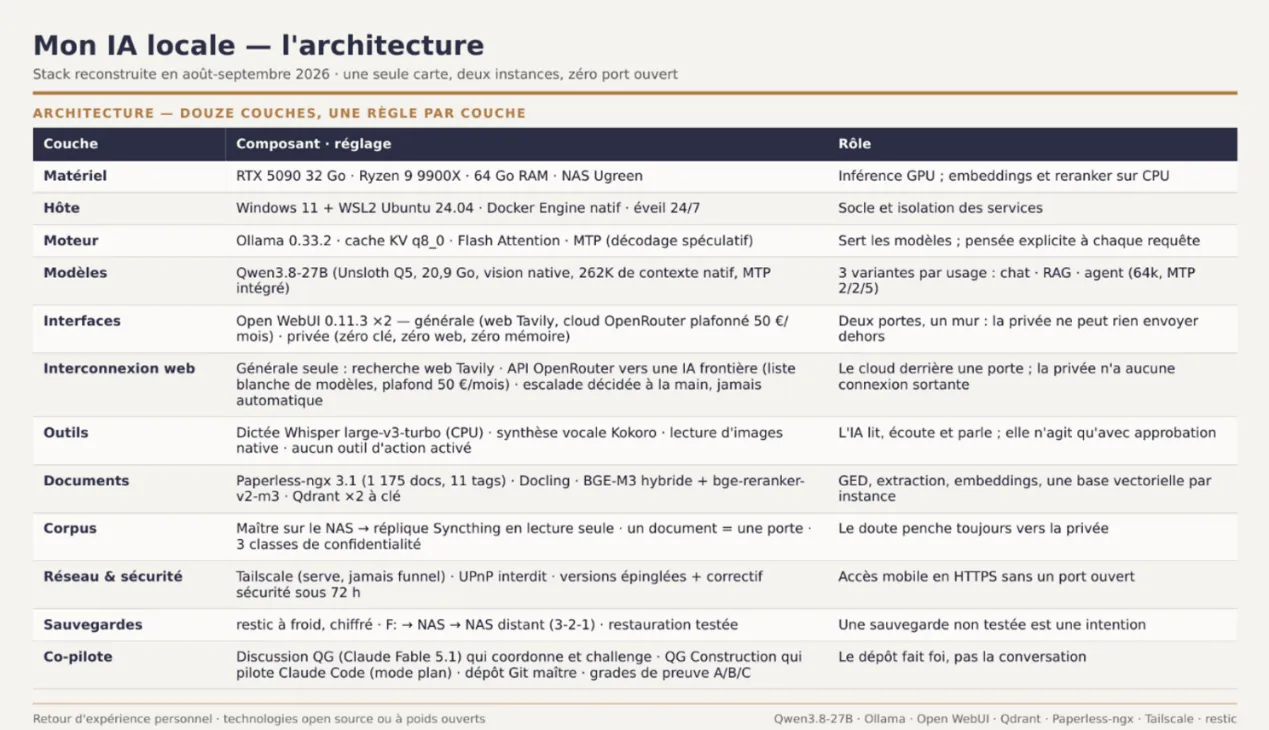
Pour les plus curieux, voici le plan d’assemblage de cette stack, structurée en douze couches étanches :
Version texte du tableau
| Couche | Composant · réglage | Rôle |
|---|---|---|
| Matériel | RTX 5090 32 Go · Ryzen 9 9900X · 64 Go RAM · NAS Ugreen | Inférence GPU ; embeddings et reranker sur CPU |
| Hôte | Windows 11 + WSL2 Ubuntu 24.04 · Docker Engine natif · éveil 24/7 | Socle et isolation des services |
| Moteur | Ollama 0.33.2 · cache KV q8_0 · Flash Attention · MTP (décodage spéculatif) | Sert les modèles ; pensée explicite à chaque requête |
| Modèles | Qwen3.8-27B (Unsloth Q5, 20,9 Go, vision native, 262K de contexte natif, MTP intégré) | 3 variantes par usage : chat · RAG · agent (64k, MTP 2/2/5) |
| Interfaces | Open WebUI 0.11.3 ×2 — générale (web Tavily, cloud OpenRouter plafonné 50 €/mois) · privée (zéro clé, zéro web, zéro mémoire) | Deux portes, un mur : la privée ne peut rien envoyer dehors |
| Interconnexion web | Générale seule : recherche web Tavily · API OpenRouter vers une IA frontière (liste blanche de modèles, plafond 50 €/mois) · escalade décidée à la main, jamais automatique | Le cloud derrière une porte ; la privée n’a aucune connexion sortante |
| Outils | Dictée Whisper large-v3-turbo (CPU) · synthèse vocale Kokoro · lecture d’images native · aucun outil d’action activé | L’IA lit, écoute et parle ; elle n’agit qu’avec approbation |
| Documents | Paperless-ngx 3.1 (1 175 docs, 11 tags) · Docling · BGE-M3 hybride + bge-reranker-v2-m3 · Qdrant ×2 à clé | GED, extraction, embeddings, une base vectorielle par instance |
| Corpus | Maître sur le NAS → réplique Syncthing en lecture seule · un document = une porte · 3 classes de confidentialité | Le doute penche toujours vers la privée |
| Réseau & sécurité | Tailscale (serve, jamais funnel) · UPnP interdit · versions épinglées + correctif sécurité sous 72 h | Accès mobile en HTTPS sans un port ouvert |
| Sauvegardes | restic à froid, chiffré · F: → NAS → NAS distant (3-2-1) · restauration testée | Une sauvegarde non testée est une intention |
| Co-pilote | Discussion QG (Claude Fable 5.1) qui coordonne et challenge · QG Construction qui pilote Claude Code (mode plan) · dépôt Git maître · grades de preuve A/B/C | Le dépôt fait foi, pas la conversation |
Sous le capot : Anatomie d’une requête
Pour les curieux du système, voici ce qui se passe quand je traite une simple facture d’électricité :
- Numérisation : La facture est scannée dans Paperless-ngx (sur mon NAS). Une étiquette dédiée la dirige vers la bonne collection, selon une liste blanche que j’ai écrite.
- Traitement : Copie transmise au PC. Docling extrait le texte et les tableaux et découpe le tout en fragments ; BGE-M3 transforme chaque fragment en vecteur, rangé dans la base Qdrant.
- Interrogation : Depuis mon téléphone (via le tunnel sécurisé Tailscale), je demande : « Combien ai-je payé l’électricité en mars ? »
- Réponse : Open WebUI interroge Qdrant, isole les 4 passages clés, Ollama transmet à Qwen3.8-27B, et la réponse arrive, source à l’appui.
Tout l’écosystème repose sur des briques robustes (PostgreSQL, Redis, Whisper pour la voix) surveillées par des scripts de santé quotidiens et sauvegardées chaque semaine sur un NAS secondaire.
Le prochain défi : Les agents
La prochaine étape s’appelle l’autonomie. Un chatbot répond ; un agent agit. Avec des frameworks ouverts comme Hermes Agent ou OpenClaw, la théorie est belle. Mais la réalité mathématique rappelle à la prudence : si chaque étape d’un processus réussit à 90 %, un enchaînement de 10 actions n’a plus que 35 % de chances d’aboutir correctement.
Mes consignes sont donc strictes :
- Validation humaine obligatoire sur chaque action.
- Pas de mode autonome non surveillé.
- Répertoire de travail hermétique.
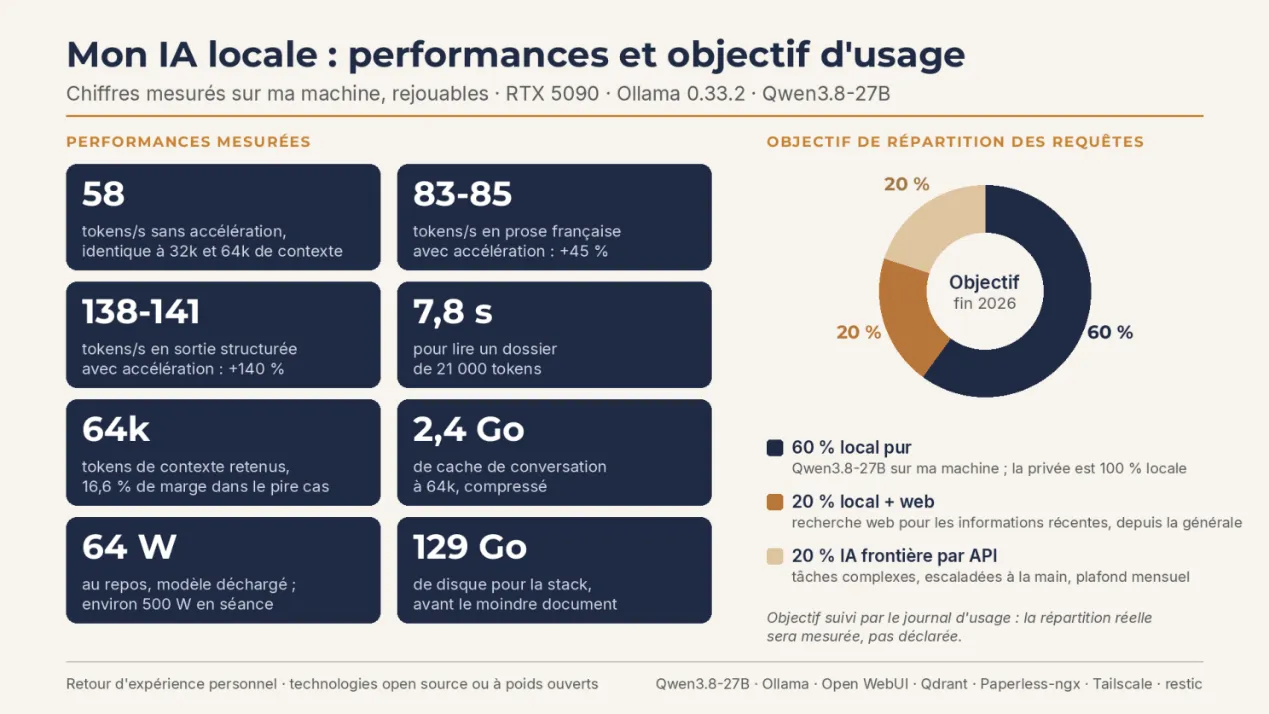
Le détail des performances mesurées et de l’équilibrage de mes requêtes :
Version texte de l’infographie
Performances mesurées (chiffres mesurés sur ma machine, rejouables · RTX 5090 · Ollama 0.33.2 · Qwen3.8-27B)
| Mesure | Ce qui est mesuré |
|---|---|
| 58 tokens/s | sans accélération, identique à 32k et 64k de contexte |
| 83-85 tokens/s | en prose française avec accélération : +45 % |
| 138-141 tokens/s | en sortie structurée avec accélération : +140 % |
| 7,8 s | pour lire un dossier de 21 000 tokens |
| 64k | tokens de contexte retenus, 16,6 % de marge dans le pire cas |
| 2,4 Go | de cache de conversation à 64k, compressé |
| 64 W | au repos, modèle déchargé ; environ 500 W en séance |
| 129 Go | de disque pour la stack, avant le moindre document |
Objectif de répartition des requêtes, fin 2026
- 60 % local pur : Qwen3.8-27B sur ma machine ; la privée est 100 % locale
- 20 % local + web : recherche web pour les informations récentes, depuis la générale
- 20 % IA frontière par API : tâches complexes, escaladées à la main, plafond mensuel
Objectif suivi par le journal d’usage : la répartition réelle sera mesurée, pas déclarée.
Mon mix cible pour la fin de l’année ? 60 % en local, 20 % en local + web, et 20 % de cloud frontière pour les gros os à ronger. Le tout dans la même interface. Je ne cherche plus à fuir le cloud : je décide quand j’ouvre la porte.
Épilogue : Un an après, le bilan
Mes trois craintes initiales ont pris une tournure inattendue.
Le prix : Je visais à côté. Les prix des jetons cloud ont été divisés par 1 000 en 18 mois. Ce sont les composants qui ont flambé, et j’ai les factures pour le prouver : ma RTX 5090, payée 2 099 € en septembre 2025, s’affiche aujourd’hui à 5 600 € chez le même revendeur ; mes 64 Go de DDR5 6000 MT/s, de la mémoire haute performance payée 179 € à l’époque, valent 1 257 €, sept fois plus. Mon PC vaut aujourd’hui plus cher qu’à l’achat. Je m’inquiétais du prix de l’abonnement ; c’est le prix de la machine qui a explosé, et de loin. Côté électricité, rien à signaler : 64 W au repos, 500 W en pleine charge, soit une quinzaine d’euros par mois.
2 099 €
RTX 5090, prix payé
5 600 €
La même carte, prix affiché aujourd’hui chez le même revendeur
179 €
64 Go de DDR5 6000 MT/s, prix payé
1 257 €
Les mêmes 64 Go, leur valeur aujourd’hui
64 W
Consommation au repos
500 W
Consommation en pleine charge
15 €/mois
Électricité : une quinzaine d’euros par mois
Les données : Mon intuition initiale s’est confirmée. La sécurité ne doit pas reposer sur une promesse, mais sur la physique. Mon interface privée est totalement cloisonnée : zéro clé d’accès au cloud, zéro connexion Internet. Même si le modèle décidait d’exfiltrer un document, il n’a physiquement aucune porte de sortie. Pour en avoir le cœur net, j’ai mené mon propre test d’intrusion en glissant une prompt injection (un ordre malveillant caché dans un fichier) au milieu de mes documents. L’IA a repéré le piège, l’a signalé, et n’a rien exécuté. Le coffre-fort tient bon.
La souveraineté : Le 3 septembre, l’institut de recherche émirati MBZUAI a publié six modèles avec leur code, leurs données et leur recette complète, sous licence Apache 2.0 : l’open source au sens plein, pour la première fois à cette échelle. De quoi, peut-être, donner des idées à d’autres laboratoires.
Ce que je fais tourner reste un gâteau : excellent, gratuit, mais dont personne ne lit la recette. Et peu importe qu’un modèle soit développé en Chine ou aux États-Unis. Ce qui compte, c’est où il s’exécute. S’il tourne sous mon bureau sans accès réseau, mes données restent à moi ; le même modèle appelé sur l’API de son fournisseur ne l’est plus.
Le cloud m’a pourtant rattrapé trois fois :
- Pour tout coder : N’étant pas développeur de métier, j’ai bâti cet écosystème en m’appuyant sur Claude via ma méthode de pilotage à plusieurs niveaux. La boutade de l’Acte 1 (utiliser Internet Explorer pour télécharger Chrome) est littéralement devenue ma méthode de travail. Mais la suite logique s’impose : rapatrier le code en local. C’était inenvisageable il y a un an. Aujourd’hui, des modèles spécialisés en développement tiennent sur mes 32 Go de VRAM et peuvent ingurgiter l’intégralité d’un projet d’un seul trait. Leurs scores sur les benchmarks d’agents autonomes sont bluffants. Certes, aucun ne détrône encore Claude. Mais l’écart s’est suffisamment réduit pour justifier la prochaine étape : lancer le match à domicile, sur mon propre code.
- Comme porte de secours : Disponible uniquement quand je l’ordonne.
- Comme fournisseur de modèles : Alibaba, Google, OpenAI… la marque importe peu, seul compte le niveau de contrôle.
Le patron de Mistral (Arthur Mensch) le dit lui-même : la compétition ne se joue plus sur l’entraînement des modèles, mais sur les interfaces et l’intégration. Ce que j’ai construit en un an n’est pas un modèle. C’est une architecture qui me permet d’en changer sans rien casser.
Et maintenant ? Du PC de salon à l’entreprise
Cette aventure a démarré comme un défi personnel sous un bureau. Néanmoins, elle m’a apporté des repères précis, des chiffres réels et une compréhension concrète des limites du local.
Aujourd’hui, dans mon métier, je croise des entreprises confrontées exactement aux mêmes arbitrages, mais à plus grande échelle : Quelles données confier au cloud ? Quels modèles déployer en interne ? Comment garantir la sécurité sans transformer le projet en démo technique permanente ?
Un chiffre pour situer l’urgence : entre 50 et 75 % des salariés du tertiaire confient déjà des documents professionnels à une IA grand public, sur leur compte personnel. Interdire ne marche pas ; on n’endigue le Shadow AI qu’en offrant mieux (ou a minima aussi bien).
Ce n’est pas tant la loi qui presse : l’AI Act est entré dans sa phase répressive le 2 août, mais ses obligations lourdes sont reportées à fin 2027. C’est la confidentialité qui presse. Et le principe qui structure les déploiements sérieux tient en quatre mots : une organisation, un serveur. Mutualiser entre clients, c’est reconstituer un cloud partagé et perdre ce qu’on venait précisément chercher.
Mais le point central, et le plus stratégique pour un décideur, est ailleurs : ce qu’on a déjà n’est pas digéré. C’est ce que Sam Altman a popularisé sous l’expression de « capability overhang ». Concrètement : les modèles existants sont déjà infiniment plus capables que ce que la société et nos entreprises en font. Si toute la R&D mondiale s’arrêtait demain matin, l’économie aurait dix ans de transformation à intégrer rien qu’avec les outils déjà disponibles.
Il ne s’agit évidemment pas de coller une RTX 5090 sous le bureau de chaque collaborateur. Passer à l’échelle d’une organisation exige l’intervention d’architectes, d’experts sécurité et d’intégrateurs. Mais mon laboratoire personnel m’a donné un avantage précieux : savoir ce qui se passe vraiment de l’autre côté de l’écran.
À l’échelle de centaines d’utilisateurs, la vraie question n’est plus de savoir si le local est « meilleur » que le cloud. Il s’agit d’architecturer un système hybride, maîtrisé et évolutif. Je n’ai pas quitté le navire du cloud. J’ai simplement appris à choisir ce que je lui confie, et surtout à garder sous mon contrôle tous les matelots qui gagnent à le rester.
Plonger dans l’open-weight, c’est aussi découvrir une communauté fascinante où l’entraide et le partage sont la règle d’or. Et même si l’écosystème peut regretter le récent virage des « Frenchies » de Hugging Face, je reste foncièrement optimiste pour la suite quand je vois Jensen Huang (le patron de Nvidia) continuer de soutenir massivement les modèles à poids ouverts. Cela n’engage que moi, mais j’ai ma petite théorie : une fois les datacenters mondiaux saturés, je parie qu’il viendra équiper nos foyers et nos entreprises pour entretenir sa folle ascension boursière !
Vous hébergez des modèles sur vos propres machines ? N’hésitez pas à partager vos configurations et vos retours d’expérience en commentaire, la discussion est ouverte !
Si vous êtes DSI, dirigeant ou simplement en réflexion sur le déploiement maîtrisé de l’IA dans votre structure, mes MP sont ouverts. Le but n’est certainement pas de dupliquer mon installation, qui répond à des besoins personnels, mais de concevoir ensemble l’architecture adaptée à vos enjeux (accompagnés d’experts IA dont c’est le métier).
Pour ce qui est de l’année 2 de ma station, le rendez-vous est pris : on se retrouve le 10 septembre 2027 pour le bilan final. Le verdict a désormais une date.
À très vite pour la suite,
>_ Rachid